Em ecossistemas digitais modernos, nenhuma aplicação opera de forma isolada. Operações corporativas dependem diariamente de dezenas de APIs de terceiros e microserviços externos — gateways de pagamento, autorizadores de nota fiscal eletrônica (SEFAZ), cotações de frete, serviços de mensageria e bureaus de crédito. No entanto, depender de serviços externos introduz uma variável incontrolável: a instabilidade do parceiro.
Quando uma API de terceiros sofre oscilações de latência ou passa por uma queda total, integradores ingênuos tentam reenviar requisições de forma síncrona e desordenada. Esse comportamento provoca o acúmulo de threads bloqueadas no sistema principal, gerando esgotamento do pool de conexões, travamento da aplicação e colapso em cadeia de toda a infraestrutura corporativa (cascading failures).
Transformar sistemas frágeis em plataformas imunizadas a falhas exige a implementação rigorosa de Padrões de Resiliência Distribuída. Utilizando os ecossistemas Polly (C# / .NET), Resilience Go / Hystrix-Go (Golang) e Tenacity / PyBreaker (Python), aplicamos os padrões Circuit Breaker (Disjuntor), Retry com Exponential Backoff e Jitter (Retentativas Espaçadas) e Bulkhead Isolation (Isolamento de Compartimentos).
Neste artigo, detalhamos como essa tríade de engenharia protege os sistemas corporativos contra oscilações de fornecedores e garante a continuidade operacional mesmo durante crises extremas de infraestrutura externa.
1. A Anatomia do Colapso por Falhas de Parceiros Terceirizados
A ausência de políticas de resiliência na camada de integração expõe a empresa a três riscos sistêmicos graves:
- Efeito Cascata e Esgotamento de Threads: Atrasos na resposta de uma API externa (ex: resposta demorando 30 segundos em vez de 200 milissegundos) fazem com que as threads do middleware fiquem retidas. Em poucos minutos, todo o pool de execução do servidor é consumido, derrubando módulos internos que sequer dependiam daquela integração.
- Efeito "Thundering Herd" e Tempestade de Retentativas: Tentar reenviar requisições imediatamente após uma falha (naive retry) amplifica a carga sobre um serviço parceiro que já está instável, impedindo a sua recuperação e gerando bloqueios em massa de IP/Rate-limit.
- Falta de Fallback Graceful: Falhar categoricamente exibindo erros genéricos para o usuário final em vez de oferecer caminhos alternativos de degradação suave (degraded mode).
2. A Tríade da Imunização Distribuída: Circuit Breaker, Retry e Bulkhead
A arquitetura de resiliência atua como um escudo de contenção entre o núcleo da empresa e os fornecedores externos:
A. Circuit Breaker (O Disjuntor Eletrônico)
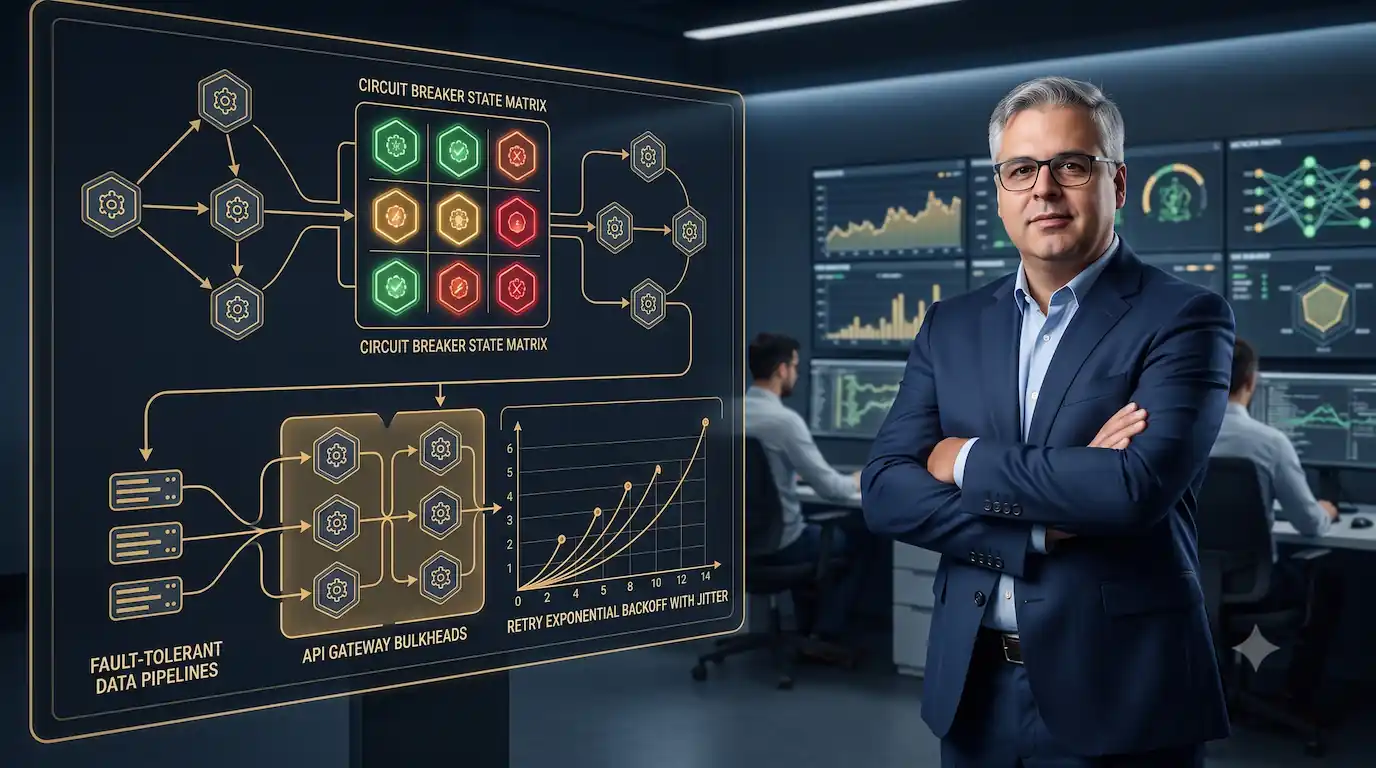
O padrão Circuit Breaker monitora a taxa de falhas ou latência das chamadas para a API parceira. O disjuntor opera em três estados:
- Fechado (Closed): Operação normal. As chamadas fluem para o parceiro.
- Aberto (Open): Caso a taxa de erro ultrapasse o limite configurado (ex: 50% de falhas nos últimos 10 segundos), o disjuntor "abre". Todas as chamadas subsequentes são interrompidas imediatamente na borda sem tentar conectar ao parceiro, retornando uma resposta de fallback e economizando recursos.
- Meio-Aberto (Half-Open): Após um tempo de espera (sleep window), o disjuntor permite a passagem de poucas requisições de teste. Se forem bem-sucedidas, o disjuntor fecha; se falharem, ele reabre.
B. Retry com Exponential Backoff e Jitter
Para falhas transitórias de rede, o padrão de retentativas calcula o intervalo de espera exponencialmente entre cada tentativa (1s, 2s, 4s, 8s...). Para evitar que milhares de instâncias da sua aplicação tentem reconectar simultaneamente criando picos de tráfego, adicionamos variação aleatória (Jitter), distribuindo as retentativas uniformemente no tempo.
C. Bulkhead Isolation (Isolamento por Compartimentos Sequeados)
Inspirado nas divisórias estanques dos cascos de navios que impedem que um vazamento em um compartimento afunde a embarcação inteira, o padrão Bulkhead estabelece limites estritos de conexões simultâneas por serviço. Se a API de frete congelar, ela só poderá consumir até o seu limite alocado (ex: 20 conexões), mantendo o restante da infraestrutura (90% da capacidade) livre para processar pagamentos e cadastros.
3. Implementação Multilinguagem de Alta Performance
A estratégia da LinspTI utiliza as bibliotecas mais maduras de resiliência em cada ecossistema:
- Em C# / .NET 8 (Polly): Utilização das novas pipelines de resiliência do
Microsoft.Extensions.Resilience, combinando Rate Limiter, Circuit Breaker, Hedging e Timeout nativos com baixa alocação de memória. - Em Go (Golang - Resilience Go / Hystrix-Go): Utilização de canais nativos e contexto (
context.WithTimeout) combinados a estruturas de Circuit Breaker para processamento concorrente ultrarrápido sob baixíssimo consumo de CPU. - Em Python (Tenacity / PyBreaker): Aplicação de decoradores assíncronos (
@retry/@circuitbreaker) integrados ao ciclo de eventos deasyncio, garantindo não-bloqueio de I/O durante tentativas de reconexão.
4. Impacto Operacional na Continuidade do Negócio e SRE
A implementação de resiliência distribuída redefine os indicadores de estabilidade da TI corporativa:
- Cumprimento Rigoroso do SLA de Disponibilidade (99.99% Up-time): Quedas de fornecedores terceirizados deixam de derrubar o seu ecossistema corporativo.
- Preservação de Experiência do Usuário (Degradação Graciosa): Se o serviço de cálculo de frete sair do ar, o sistema exibe um frete estimado baseado em histórico em vez de travar o carrinho de compras.
- Mitigação de Chamados Críticos de Emergência (Zero War-Rooms): A infraestrutura recupera-se autonomamente de falhas de terceiros sem necessidade de intervenção manual da equipe de SRE na madrugada.
5. Roteiro de Implementação de Resiliência em Integrações Críticas
Adicionar bibliotecas de resiliência ao código não é o primeiro passo — é preciso primeiro entender onde estão as dependências frágeis:
- Fase 1 — Mapeamento do grafo de dependências externas: listar todas as APIs de terceiros consumidas pela aplicação e classificar cada uma por criticidade (bloqueante vs. degradável) e histórico de instabilidade.
- Fase 2 — Definição de limites e SLAs por integração: estabelecer, para cada dependência, o timeout aceitável, o limite de concorrência (Bulkhead) e o critério de abertura do Circuit Breaker (ex: 50% de erro em 10s).
- Fase 3 — Implementação incremental por criticidade: aplicar os padrões primeiro nas integrações que já causaram incidentes (pagamento, SEFAZ), validando com Chaos Testing antes de expandir às demais.
- Fase 4 — Monitoramento contínuo de estado dos disjuntores: instrumentar dashboards que mostrem em tempo real quais Circuit Breakers estão abertos, permitindo à equipe de SRE agir antes que o efeito cascata se espalhe.
6. Erros Mais Comuns na Adoção de Padrões de Resiliência
Implementar as bibliotecas certas não garante resiliência se as configurações básicas estiverem erradas:
- Retentar erros não-transitórios: configurar retry genérico para qualquer código de erro, inclusive 400/422, apenas multiplica a carga sobre um problema que retry nenhum vai resolver.
- Circuit Breaker sem estado Meio-Aberto bem calibrado: um tempo de espera (sleep window) curto demais reabre o disjuntor prematuramente contra um serviço ainda instável; longo demais atrasa a recuperação depois que o parceiro já normalizou.
- Ausência de fallback real: implementar o Circuit Breaker só para "falhar rápido" sem definir uma resposta de degradação graciosa transfere o mesmo erro genérico ao usuário final, só que mais cedo — sem entregar o benefício de continuidade operacional.
Perguntas Frequentes sobre Circuit Breaker e Resiliência Distribuída
Qual a diferença entre Circuit Breaker e simplesmente configurar um timeout mais curto?
O timeout limita quanto tempo uma chamada individual espera; o Circuit Breaker observa o histórico de chamadas (seção 2.A) e interrompe novas tentativas na borda, sem sequer tentar conectar, quando a taxa de falha ultrapassa um limite configurado. Um timeout curto sozinho ainda deixa a aplicação tentando conectar repetidamente a um serviço já instável, sem economizar recursos do pool de conexões nem evitar o efeito cascata.
Retry com Exponential Backoff resolve qualquer tipo de falha externa?
Não. Retry é indicado para falhas transitórias de rede (timeout pontual, erro 503 momentâneo), mas retentar uma chamada que retorna erro 400 ou 422 (dado inválido) apenas repete o mesmo erro sem nenhuma chance de sucesso, desperdiçando tempo e recursos do pool. É preciso classificar o tipo de erro antes de decidir se ele é elegível para retry — ver seção de erros comuns acima.
Bulkhead Isolation é necessário mesmo com Circuit Breaker já implementado?
Sim, são camadas complementares descritas na seção 2. O Circuit Breaker decide quando parar de chamar um serviço instável, mas não impede que uma integração lenta (mesmo sem estar "quebrada") consuma todas as threads disponíveis antes do disjuntor abrir. O Bulkhead limita a concorrência máxima por serviço, contendo o dano mesmo durante a janela em que o Circuit Breaker ainda está fechado.
Como testar se os padrões de resiliência realmente funcionam antes de um incidente real?
Através de Chaos Testing: injeção deliberada de latência, queda forçada de um serviço parceiro simulado e picos de erro em ambiente controlado, medindo se o Circuit Breaker abre no limite esperado, se o Bulkhead contém o consumo de recursos e se o fallback é acionado corretamente. Validar isso em produção pela primeira vez durante um incidente real, como aponta a seção 3, é tarde demais.
Como a LinspTI Resolve Este Problema na Sua Empresa
A LinspTI combina senioridade em arquitetura de sistemas distribuídos, engenharia de software de alta performance, perícia em TI e práticas avançadas de SRE para imunizar sua infraestrutura contra instabilidades do ecossistema externo.
Para CTOs, Engenheiros de Confiabilidade e Arquitetos de Soluções que buscam garantir a continuidade absoluta do negócio diante de fornecedores instáveis, a LinspTI entrega:
- Auditoria de Resiliência & Mapeamento de Pontos Únicos de Falha (SPOF): Análise arquitetural detalhada em todo o grafo de dependências e APIs de terceiros para identificar vulnerabilidades de cascading failure.
- Implementação de Pipelines de Resiliência Multilinguagem (Polly / Go / Python): Construção de middlewares com políticas customizadas de Circuit Breaker, Exponential Backoff, Jitter e Bulkhead.
- Engenharia de Chaos Testing & Testes de Resiliência: Simulação prática de falhas de rede, injeção de latência e queda forçada de parceiros em ambiente controlado para comprovar a eficiência das barreiras de contenção.
- Estratégias de Fallback & Degradação Graciosa: Modelagem de rotas alternativas de processamento e caches resilientes para manter o negócio faturando mesmo durante indisponibilidades externas.
Fontes e Referências Bibliográficas
- Nygard, M. T. (2018). Release It!: Design and Deploy Production-Ready Software. Pragmatic Bookshelf.
- App-vNext. (2024). Polly: The .NET Resilience and Transient-Fault-Handling Library. pollydocs.org.
- Resilience4j & Go Resilience Core Teams. (2023). Fault Tolerance Patterns in Distributed Microservices. IEEE Software.
- LinspTI Repository & Corporate Publications. Engenharia de Software, Resiliência em Sistemas Distribuídos e Padrões Circuit Breaker. linspti.com.br.