Em um ambiente corporativo globalizado e digitalmente dependente, onde transações financeiras, operações logísticas e serviços de saúde ocorrem em frações de segundo, uma interrupção não planejada na infraestrutura de nuvem deixa de ser um mero incidente técnico para se transformar em uma crise financeira e reputacional catastrófica. Catástrofes regionais de datacenters, falhas generalizadas de redes de fibra óptica submarina ou corrupções estruturais de banco de dados podem derrubar regiões inteiras de nuvem de grandes provedores.
Muitas organizações acreditam estar protegidas por simples rotinas de backup diário em disco ou replicação assíncrona básica. No entanto, quando ocorre uma falha catastrófica, a realidade operacional impõe métricas implacáveis: o RPO (Recovery Point Objective) — o volume aceitável de perda de dados — e o RTO (Recovery Time Objective) — o tempo necessário para restaurar a operação. Em sistemas críticos, perder horas de transações (RPO elevado) ou ficar offline por um dia inteiro (RTO prolongado) resulta em multas regulatórias severas e perda irreversível de clientes.
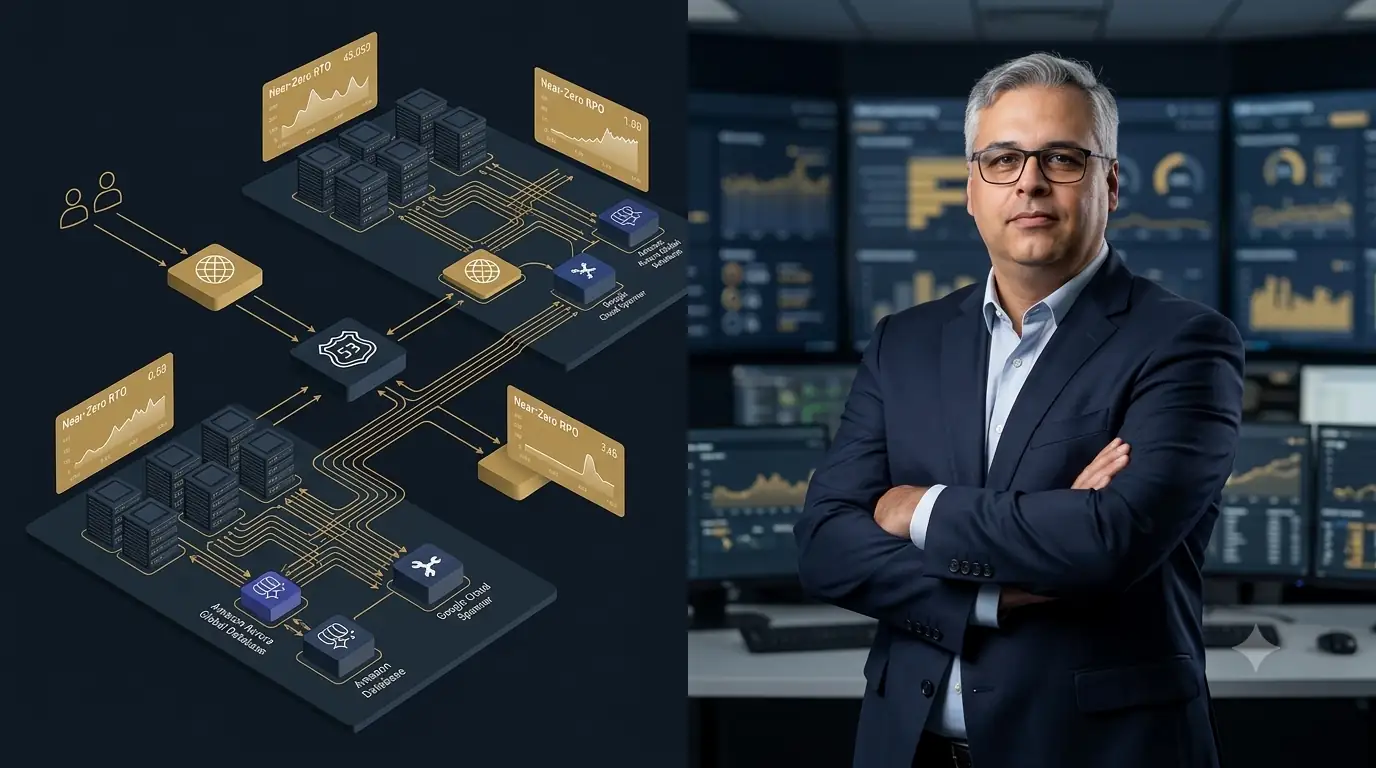
A resposta arquitetural definitiva para garantir resiliência absoluta é a implementação de Estratégias Multi-Region Ativo-Ativo (Active-Active). Utilizando recursos avançados de roteamento inteligente na borda como AWS Route 53, replicação transacional global com Amazon Aurora Global Database, bancos de dados globalmente consistentes como Google Cloud Spanner e Multi-Region Storage, as empresas mantêm operações simultâneas em múltiplos continentes com RTO e RPO próximos de zero e failover totalmente automatizado.
Neste artigo, detalhamos os modelos de recuperação de desastres, as arquiteturas de bancos de dados globalmente distribuídos e a governança de alta disponibilidade em ambientes multi-cloud.
1. O Risco Oculto das Estratégias de Recuperação Tradicionais (Backup e Multi-AZ)
Confiar apenas em cópias de backup tradicionais ou em redundância de Zona de Disponibilidade única (Multi-AZ) expõe a corporação a vulnerabilidades sistêmicas em casos extremos:
- Vulnerabilidade a Incidentes Regionais Amplos: Embora zonas de disponibilidade protejam contra quedas de hardware isoladas, um desastre estrutural, falha em serviços globais de DNS ou corrupções lógicas em larga escala podem comprometer uma região inteira do provedor de nuvem simultaneamente.
- RTO Inaceitável em Recuperações Manuais: Depender de equipes de engenharia para reescrever configurações de DNS, restaurar backups de terabytes do zero e subir servidores manualmente eleva o tempo de inatividade para horas ou dias.
- Perda Irrecuperável de Transações Recentes (RPO Elevado): Sistemas com replicação assíncrona tradicional perdem todas as transações ocorridas nos minutos anteriores à queda do datacenter principal, gerando furos contábeis e quebra de contratos B2B.
2. A Arquitetura Multi-Region Ativo-Ativo na AWS e no GCP
A solução arquitetural distribui a carga de trabalho transacional de forma síncrona ou com baixíssima latência entre duas regiões geográficas distintas:
A. Roteamento Inteligente na Borda com AWS Route 53
O AWS Route 53 atua como o controlador de tráfego global utilizando políticas de roteamento baseadas em latência, geolocalização e checagens de saúde (Health Checks). Caso a Região A apresente falhas em suas rotas ou latência anômala, o Route 53 redireciona automaticamente 100% do tráfego corporativo para a Região B em segundos, de forma totalmente transparente para o usuário final.
B. Consistência Transacional Global com Amazon Aurora e Google Cloud Spanner
Para eliminar a perda de dados, a camada de persistência utiliza tecnologias de banco de dados distribuído globalmente:
- Amazon Aurora Global Database: Replica dados entre regiões físicas da AWS com latência típica inferior a um segundo, permitindo leitura local e failover de gravação (write failover) em menos de um minuto sem perda de dados (RPO ≈ 0).
- Google Cloud Spanner: O único banco de dados relacional do mercado que oferece transações ACID globalmente consistentes e escalabilidade horizontal nativa com garantia de disponibilidade de 99,999%, unindo a robustez do modelo relacional à resiliência de sistemas distribuídos geograficamente.
C. Armazenamento de Objetos Multi-Region e Sincronização de Estado
Assets estáticos, documentos enviados e arquivos binários de clientes são armazenados em buckets AWS S3 Multi-Region Access Points ou Google Cloud Multi-Region Storage. Os objetos são replicados automaticamente em segundo plano entre continentes, garantindo que qualquer aplicativo em qualquer região acesse exatamente a mesma versão dos dados.
D. Testes Automatizados de Failover (Chaos Engineering)
Arquiteturas de alta disponibilidade não podem ser validadas apenas na teoria. A engenharia de confiabilidade moderna aplica práticas de Chaos Engineering (utilizando ferramentas como AWS Fault Injection Simulator) para derrubar proativamente regiões inteiras de teste durante o expediente, garantindo que os scripts de failover automatizado funcionem sem falhas humanas.
3. Impacto Operacional, Conformidade e Continuidade de Negócio
A maturidade em arquiteturas Multi-Region Ativo-Ativo redefine a estabilidade corporativa:
- Eliminação de Prejuízos por Downtime: Preservação da receita operacional e cumprimento rigoroso de SLAs contratuais com parceiros B2B e clientes finais.
- Cumprimento de Requisitos Regulatórios Severos: Atendimento a exigências normativas de bancos centrais, órgãos de saúde e reguladores de mercado que exigem planos homologados de continuidade de negócios.
- Tranquilidade Executiva e Governança de SRE: A diretoria de tecnologia opera com a certeza matemática de que falhas de infraestrutura regional não paralisam a empresa.
4. Roteiro de Implementação Multi-Region Ativo-Ativo
Migrar de Multi-AZ para Ativo-Ativo entre regiões é um projeto de resiliência incremental, não uma virada de chave única:
- Fase 1 — Classificação de criticidade por componente: mapear quais sistemas realmente exigem RTO/RPO próximos de zero (checkout, autenticação, dados transacionais) e quais podem seguir num modelo mais simples de backup/restore.
- Fase 2 — Escolha e migração da camada de dados distribuída: mover os componentes críticos para Amazon Aurora Global Database ou Google Cloud Spanner, validando a latência de replicação real entre as regiões-alvo.
- Fase 3 — Roteamento inteligente e health checks: configurar AWS Route 53 (ou equivalente) com políticas de latência/geolocalização e health checks agressivos o suficiente para detectar degradação regional antes da indisponibilidade total.
- Fase 4 — Chaos Engineering programado: validar o failover automatizado com testes controlados de queda de região, em janelas programadas, antes de confiar no plano para um incidente real.
5. Armadilhas Comuns em Projetos de Disaster Recovery Multi-Region
A maior parte dos planos de DR que falham no incidente real carrega um destes três problemas, não detectados em condições normais:
- Nunca testar o failover de verdade: um plano de DR documentado, mas nunca exercitado via Chaos Engineering, costuma falhar por detalhes de configuração que só aparecem sob carga real — descoberto tarde demais, durante o próprio desastre.
- Replicar a stack inteira sem priorização de criticidade: tentar dar Ativo-Ativo a todos os sistemas, inclusive os não-críticos, eleva o custo de forma desproporcional ao ganho real de resiliência.
- Ignorar a consistência de dados no desenho do failover: assumir replicação assíncrona simples como suficiente para RPO ≈ 0, sem confirmar as garantias reais da tecnologia de banco escolhida, gera inconsistência silenciosa exatamente no momento em que a integridade dos dados mais importa.
Perguntas Frequentes sobre Disaster Recovery Multi-Region
Qual a diferença entre Disaster Recovery Multi-Region e alta disponibilidade Multi-AZ?
Multi-AZ protege contra falha de um datacenter isolado dentro da mesma região geográfica, mas não contra um incidente que afete a região inteira (falha de serviços globais, desastre estrutural, corrupção lógica em larga escala). Multi-Region distribui a carga entre regiões geograficamente distintas, então um incidente regional completo não derruba a operação — o tráfego é redirecionado para a região saudável.
Arquitetura Multi-Region Ativo-Ativo é viável para empresas de médio porte, ou só para grandes corporações?
É viável, mas o escopo deve ser calibrado ao risco real: nem todo sistema precisa de RTO/RPO próximos de zero. A recomendação é aplicar Ativo-Ativo apenas aos componentes críticos (checkout, autenticação, dados transacionais) e manter os demais em um modelo mais simples de backup/restore, o que reduz drasticamente o custo comparado a replicar a stack inteira.
Failover automatizado entre regiões pode causar inconsistência de dados?
Depende da tecnologia de banco de dados usada. Com Amazon Aurora Global Database o failover de escrita ocorre em menos de um minuto sem perda de dados confirmados; com Google Cloud Spanner a consistência transacional é global por design (ACID entre regiões). O risco de inconsistência aparece quando a aplicação assume replicação assíncrona simples sem validar o estado do failover antes de aceitar novas escritas.
Como testar um plano de Disaster Recovery sem colocar a produção em risco?
Com Chaos Engineering controlado: ferramentas como o AWS Fault Injection Simulator permitem derrubar deliberadamente componentes específicos (ou simular a queda de uma região) em janelas programadas, com escopo e tempo de teste limitados e reversão automática. Isso valida o failover real sem depender de um desastre de verdade acontecer para descobrir se o plano funciona.
Como a LinspTI Resolve Este Problema na Sua Empresa
A LinspTI combina excelência técnica em engenharia de sistemas distribuídos, arquiteturas cloud-native avançadas (AWS e GCP), práticas de Site Reliability Engineering (SRE), cibersegurança e perícia em TI para projetar ambientes corporativos imunes a indisponibilidades.
Para CTOs, Engenheiros de Confiabilidade (SRE), Diretores de Operações de TI e VPs de Tecnologia que buscam RTO e RPO próximos de zero para operações críticas, a LinspTI entrega:
- Projetos de Arquitetura Multi-Region Ativo-Ativo (AWS / GCP): Desenho e implementação de topologias de alta disponibilidade com balanceamento global de tráfego via Route 53 e failover automatizado.
- Migração e Configuração de Bancos de Dados Distribuídos: Implementação de Amazon Aurora Global Database e Google Cloud Spanner para consistência transacional sem perda de dados.
- Simulações de Desastre & Chaos Engineering: Execução controlada de testes de interrupção regional para validar a resiliência dos sistemas e a eficácia dos planos de resposta a incidentes.
- Auditoria de Resiliência & Planos de Continuidade de Negócios (BCP/DRP): Revisão pericial de infraestruturas legadas e estruturação de documentação regulatória de conformidade operacional.
Fontes e Referências Bibliográficas
- Amazon Web Services. (2024). Disaster Recovery of Workloads on AWS: Recovery in the Cloud. aws.amazon.com/disaster-recovery.
- Google Cloud. (2024). Cloud Spanner Global Architecture and Multi-Region Disaster Recovery Patterns. cloud.google.com/architecture.
- Allspaw, J., & Robbins, B. (2010). Web Operations: Keeping the Data at Time Zero. O'Reilly Media.
- LinspTI Repository & Corporate Publications. Engenharia de Software, Arquiteturas Multi-Region Ativo-Ativo e Resiliência em Nuvem. linspti.com.br.