Para grandes corporações que movimentam diariamente milhões de registros de transações financeiras, notas fiscais, logs de pagamentos e conciliações de cartões, a velocidade com que os dados operacionais são transformados em inteligência estratégica determina a capacidade de reação no mercado. No entanto, os ecossistemas tradicionais de relatórios analíticos enfrentam sérios gargalos quando submetidos a volumetrias de grande escala: relatórios financeiros que demoram horas para processar, conciliações diárias de encerramento (close cycle) travadas e painéis de BI que falham exatamente no momento em que a diretoria precisa tomar decisões críticas.
Tentar resolver a latência analítica provisionando instâncias fixas e clusters dedicados de Data Warehouse gera um dilema financeiro ineficiente. A infraestrutura fica ociosa durante a maior parte do dia e entra em colapso nos picos de fechamento contábil. Além disso, a falta de elasticidade real impede que analistas e executivos realizem consultas ad-hoc complexas sem impactar as rotinas diárias da empresa.
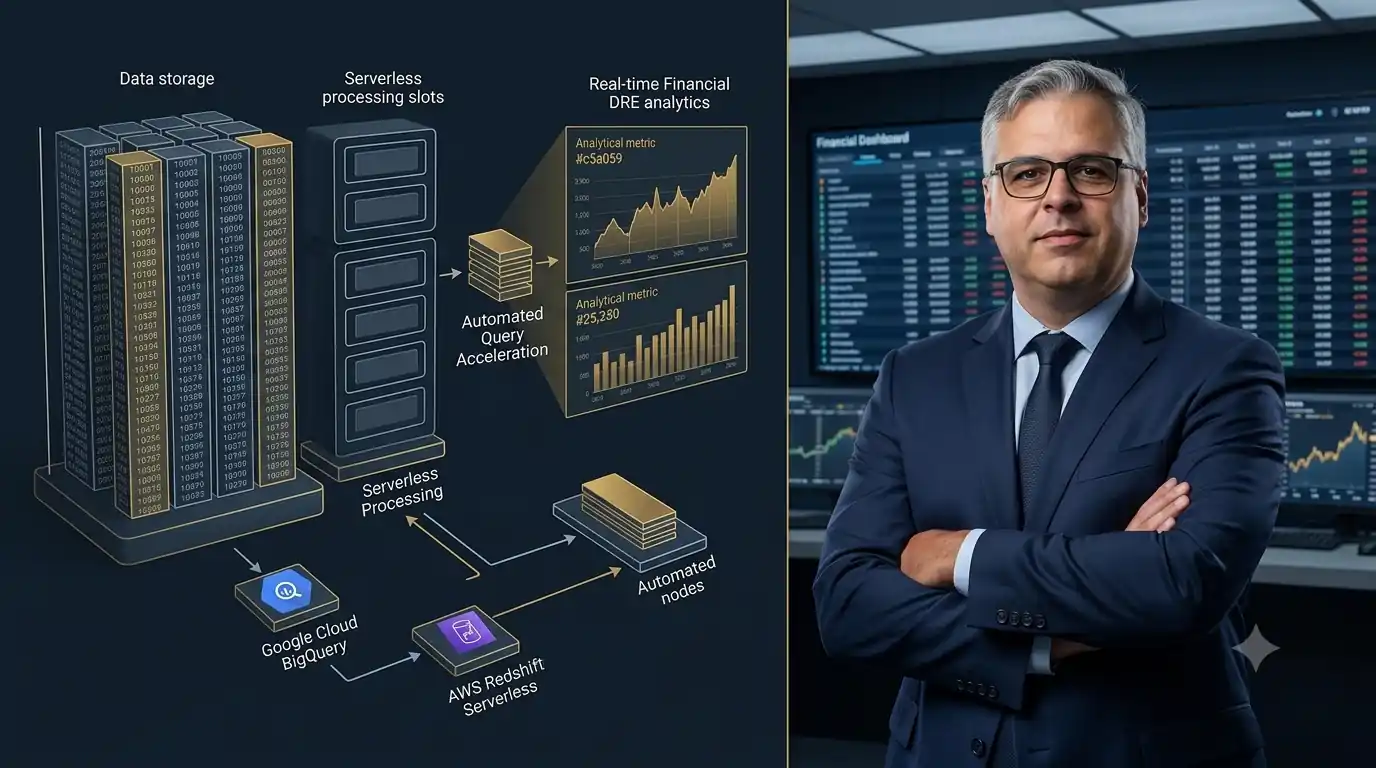
A resposta tecnológica para processar bases gigantescas em frações de segundo reside nas Arquiteturas de Data Warehouse Serverless. Comparando e combinando o poder do Google Cloud BigQuery (com seu modelo desacoplado de computação/armazenamento e slots dinâmicos) e do AWS Redshift Serverless (com autoscaling automático de Redshift Processing Units — RPUs), é possível executar consultas complexas em tabelas de centenas de milhões de linhas com alta performance, previsibilidade de custos e zero gestão de infraestrutura.
Neste artigo, analisamos as arquiteturas serverless do BigQuery e Redshift, as táticas de particionamento e otimização SQL, e o impacto direto na velocidade de tomada de decisão financeira.
1. Os Desafios do Analytics Financeiro de Grande Escala
Processar volumes massivos de dados transacionais para fins analíticos e financeiros exige superar barreiras operacionais históricas:
- Lentidão no Fechamento Contábil e DREs em Tempo Real: A incapacidade de processar o DBR (Detalhamento de Bilhetagem/Registros) e livros de razão em tempo real força os times financeiros a esperar dias após o fim do mês para consolidar o DRE corporativo.
- Gargalo de Concorrência em Horários de Pico: Quando dezenas de diretores, analistas e algoritmos preditivos executam consultas simultâneas no início da manhã, as ferramentas legadas enfileiram as requisições, gerando timeouts generalizados nos dashboards de BI.
- Explosão Indiscriminada de Custos por Consultas Ineficientes: Sem mecanismos de limite de bytes varridos e particionamento de tabelas, uma única consulta SQL mal escrita por um analista pode varrer terabytes desnecessários, resultando em cobranças surpresa na fatura de nuvem.
2. A Arquitetura Analítica Serverless com BigQuery e Amazon Redshift
A solução separa completamente o armazenamento da capacidade computacional, escalando instantes de processamento sob demanda:
A. Google Cloud BigQuery: Arquitetura Colunar e Slots Dinâmicos
O Google Cloud BigQuery foi projetado desde a sua origem como uma plataforma serverless e altamente paralela. Seu armazenamento colunar (Capacitor) e sua rede de distribuição (Jupiter) permitem separar totalmente o disco da computação. O BigQuery aloca automaticamente milhares de trabalhadores (slots) para resolver uma única consulta SQL em milissegundos. Integrado ao BigQuery BI Engine (camada de aceleração em memória), os dashboards no Power BI, Tableau ou Looker respondem a filtros instantaneamente, mesmo sobre tabelas de milhões de linhas.
B. AWS Redshift Serverless: Redshift Processing Units (RPUs) e Concorrência Dinâmica
O AWS Redshift Serverless elimina a necessidade de gerenciar e redimensionar clusters físicos de Data Warehouse. A plataforma monitora continuamente o tráfego de consultas e ajusta automaticamente a capacidade computacional em Redshift Processing Units (RPUs). Durante o fechamento financeiro do fim de mês, a infraestrutura escala de forma transparente para absorver a carga massiva e encolhe a zero nos períodos sem uso, otimizando o TCO.
C. Estratégias de Engenharia: Particionamento, Clustering e Materialized Views
Para garantir que a execução de consultas em tabelas com centenas de milhões de linhas permaneça barata e ultra-rápida, aplicamos padrões avançados de modelagem:
- Particionamento por Data/Tempo: Garante que a consulta varra estritamente a partição do período solicitado (ex: último trimestre), ignorando petabytes de dados históricos irrelevantes.
- Agrupamento (Clustering): Organiza os dados dentro das partições por chaves estratégicas de negócio (ex:
ID_Cliente,Código_FilialouTipo_Transação), reduzindo drasticamente o volume de I/O necessário. - Visões Materializadas (Materialized Views): Pré-calculam agregações financeiras complexas em segundo plano, entregando dados consolidados em milissegundos para os dashboards executivos sem reprocessar a base bruta a cada clique.
3. Impacto na Gestão Executiva e Tomada de Decisão Estratégica
A modernização da infraestrutura analítica redefine a velocidade de gestão da empresa:
- Tomada de Decisão Guiada por Dados em Tempo Real: Executivos passam a acompanhar margens operacionais, volume de vendas e risco de crédito em tempo real, em vez de depender de relatórios estáticos defasados.
- Aceleração do Ciclo de Fechamento Financeiro: Redução do tempo de consolidação do DRE e reconciliações contábeis de dias para escassos minutos.
- Previsibilidade Financeira e Controle de OpEx: A arquitetura serverless combinada a limites de cota impede estouros orçamentários, garantindo que o custo computacional acompanhe diretamente o valor gerado para o negócio.
4. Roteiro de Implementação de uma Arquitetura Analítica Serverless
Migrar um data warehouse crítico exige sequenciamento cuidadoso, não um "big bang" de fim de semana:
- Fase 1 — Auditoria de consultas e mapeamento de custos atuais: identificar quais relatórios e consultas consomem mais bytes varridos hoje, antes de qualquer decisão de particionamento.
- Fase 2 — Modelagem de particionamento e clustering: redesenhar o esquema de tabelas por data e por chave de negócio, migrando o histórico em lotes controlados.
- Fase 3 — Migração incremental por domínio: iniciar pelos data marts de menor criticidade (relatórios gerenciais) antes de tocar no fechamento contábil, validando paridade de resultados entre os dois ambientes.
- Fase 4 — Governança de custos e alertas: configurar cotas de bytes processados/RPUs, orçamento por equipe e alertas de consultas fora do padrão antes de liberar o acesso self-service amplamente.
5. Armadilhas Comuns na Migração para Data Warehouse Serverless
- Migrar tabelas "como estão", sem particionar: portar o esquema legado sem aplicar partição e clustering reproduz o full table scan no ambiente novo — e no modelo serverless, isso vira custo direto por consulta, não só lentidão.
- Liberar acesso self-service sem cotas por usuário: abrir BigQuery/Redshift a todos os analistas sem limites individuais de bytes processados costuma gerar picos de fatura no primeiro mês, justamente quando a adoção é maior.
- Manter dois warehouses em paralelo por tempo indefinido: rodar o sistema legado e o novo simultaneamente sem prazo de desligamento dobra o custo de infraestrutura e cria divergência de números entre relatórios, minando a confiança na migração.
Perguntas Frequentes sobre Data Warehouse Serverless
BigQuery Serverless ou Redshift Serverless: qual escolher?
Depende do provedor de nuvem dominante na empresa e do padrão de consulta. BigQuery tende a se destacar em cargas ad-hoc e imprevisíveis, por cobrar por bytes varridos e escalar slots automaticamente sem configuração prévia. Redshift Serverless se encaixa melhor em cargas mais previsíveis, com concorrência controlada via RPUs, e quando o restante da stack já vive na AWS. Em ambientes multi-cloud, muitas empresas mantêm os dois lado a lado, cada um servindo o domínio de dados mais próximo da nuvem de origem.
Migrar para data warehouse serverless elimina 100% dos custos imprevisíveis?
Reduz, mas não elimina sozinho — o modelo serverless troca o custo de infraestrutura ociosa pelo custo de bytes processados ou RPUs consumidas. Sem particionamento, clustering e cotas de consulta, uma query mal escrita continua podendo gerar uma fatura alta em um único mês. A previsibilidade de custo vem da combinação entre arquitetura serverless e governança de FinOps, não da tecnologia isolada.
É necessário reescrever todo o pipeline de ETL para migrar?
Não. A migração típica preserva a lógica de negócio dos pipelines existentes e concentra o esforço de reescrita nas camadas de ingestão e no DDL das tabelas (particionamento, clustering, tipos de dados). Ferramentas de ETL/ELT modernas (dbt, Dataflow, Glue) se conectam nativamente a BigQuery e Redshift, permitindo migrar a camada de transformação de forma incremental, sem parar as cargas em produção.
Quanto tempo leva uma migração típica para arquitetura serverless?
Para um data mart único de porte médio, uma migração incremental e bem auditada costuma levar de 4 a 10 semanas, incluindo validação de paridade de resultados entre o warehouse legado e o novo. O prazo cresce proporcionalmente ao número de domínios de dados e à quantidade de relatórios que dependem de estruturas de tabela específicas do sistema antigo.
Como a LinspTI Resolve Este Problema na Sua Empresa
A LinspTI combina liderança técnica em arquitetura de dados corporativa, engenharia analítica de alta volumetria, inteligência financeira, cibersegurança e perícia em TI para estruturar ecossistemas de BI imunes a lentidões.
Para Diretores de BI/Analytics, VPs de Finanças, VPs de Tecnologia, CDOs e CTOs que buscam velocidade instantânea em consultas analíticas e otimização de custos em nuvem, a LinspTI entrega:
- Projetos de Arquitetura & Migração para Data Warehouses Serverless: Implementação e migração de bancos legados para Google Cloud BigQuery e AWS Redshift Serverless.
- Engenharia de Otimização SQL & Modelagem de Dados (Particionamento/Clustering): Reestruturação de esquemas de tabelas e refatoração de queries analíticas para reduzir o tempo de execução e o custo de varredura de dados em até 80%.
- Aceleração de Dashboards Executivos (BI Engine / Materialized Views): Configuração de camadas de aceleração em memória para navegação fluida em painéis do Power BI, Tableau e Looker.
- Governança de Custos FinOps para Big Data: Implementação de cotas de processamento, alertas de consumo por equipe e regras de retenção de dados históricos em camadas frias.
Fontes e Referências Bibliográficas
- Google Cloud. (2024). BigQuery Architecture Insights: Serverless Data Warehousing at Scale. cloud.google.com/bigquery.
- Amazon Web Services. (2024). AWS Redshift Serverless Feature Deep Dive and Performance Tuning. docs.aws.amazon.com/redshift.
- Lakshmanan, V., & Tigani, J. (2019). Google BigQuery: The Definitive Guide: Data Warehousing, Analytics, and Machine Learning at Scale. O'Reilly Media.
- LinspTI Repository & Corporate Publications. Engenharia de Dados, Analytics Financeiro de Grande Escala e Data Warehousing Serverless. linspti.com.br.